Ēriks Salvadžio / Eryk Salvaggio savā personā apvieno hakeri, pētnieku, mākslinieku, kuratoru un mediju teorētiķi. Viņš ir Kembridžas universitātes pētnieks, Maksa Planka Institūta Mašīnu vizuālās kultūras pētniecības grupas loceklis, sadarbojies ar Hārvarda universitātes “metaLAB”. Viņa darbi izstādīti Pompidū centrā, Jaunajā muzejā Ņujorkā, Fotogrāfu galerijā Londonā u. c. Ar savām publikācijām "Tech Policy Press" un blogā “Cybernetic Forests” Ēriks ir izvirzījies kā viens no vadošajiem domātājiem par ģeneratīvā MI attiecībām ar mākslu un radošumu.
Elīna Reitere: – Tu šobrīd strādā pie doktora disertācijas digitālajās humanitārajās zinātnēs Kembridžas universitātē, pētot arhīvu prakses saistībā ar mākslīgo intelektu. Kā tu līdz tam nonāci?
Ēriks Salvadžio: – Mans ceļš uz doktorantūras studijām ir bijis salīdzinoši neparasts, jo man jau ir diezgan iespaidīgs zinātnisko publikāciju skaits, arī raksti par mākslu. Neparastais manā biogrāfijā ir tas, ka es jau kā tīnis veidoju internetmākslu (net art), biju ļoti jauns, kad uzzināju, ka vispār pastāv kaut kas tāds kā internets! Viens no maniem pirmajiem klikšķiem internetā bija meklēt informāciju par manu mīļāko mūzikas grupu Stereo Lab. Viņi, savukārt, bija saistīti ar Volkera Mākslas centru Minesotā, un meklēt informāciju par to bija mans otrais klikšķis internetā. Centra lapā bija tālāka saite uz ÄDA Web, uz tās es arī uzklikšķināju – tā bija interneta mākslas kolekcija, nosaukta Adas Lavleisas vārdā. Tobrīd es darbojos Bostonas apkārtnes grafiti scēnā un mani fascinēja ideja, ka cilvēks var kaut ko radīt un, pateicoties internetam, to var apskatīt pilnīgi jebkurš uz pasaules. Mans pirmais impulss bija radīt fotogrāfijas, ar kurām dalīties internetā, vēlāk sāku pētīt programmēšanas kodu un mēģināt to saprast, to uzlaužot. Tā es sāku attīstīt sava veida attiecības ar HTML materialitāti, ar interneta pārlūkprogrammām un pašu tīklu kā tādu. Šī nodarbe mani saveda kopā ar citiem cilvēkiem – piedalījos Rhizome grupā, sadarbojos ar 711 vēstkopu. Tajās kopienās, kurās es darbojos, visi bija ļoti aizrāvušies ar kritisku pieeju jaunajām tehnoloģijām, fokusējoties uz ideoloģijas jautājumiem. Manu domāšanu tobrīd ļoti ietekmēja Aleksandrs Galovejs, kritisko domāšanu par medijiem sasaistīt ar aktīvu radošo darbību man vienmēr ir bijis ļoti svarīgi.
Tagad tu veido mākslu, izmantojot ģeneratīvā mākslīgā intelekta sniegtās iespējas?
Jā, no koda, HTML un tīkla mākslas esmu pārgājis uz MI izpēti. Jo mans izejas punkts ir jautājums – kāds materiāls pastāv tiešsaistē, ar kuru es varētu strādāt. Kad uz skatuves parādījās ģeneratīvais mākslīgais intelekts, man kļuva pavisam interesanti. Es sāku trenēt pats savus GAN[1], centos ar tiem spēlēties un analītiski domāt par to, ko tie dara, kā dara, kā tie strukturē lietas, un kā es varu tos uztrenēt darīt ko citu, kas nav paredzēts.
Tehnoloģijas attīstās ārkārtīgi ātri, bet tāpat arī es! Mana prakse ir uzdot tos pašus tikko minētos jautājumus katram jaunam izgudrojumam, kurš nonāk tiešsaistes telpā. Jo tādā ziņā gan interneta māksla, gan ģeneratīvais MI ir viens un tas pats.
Vienā no saviem tekstiem tu norādi uz to, ka ģeneratīvā MI rašanās bija iespējama tikai vienā konkrētā vēsturiskā situācijā. Kāda tā bija un kāpēc ģeneratīvais MI ir kļuvis tik ārkārtīgi populārs?
Jā, ģeneratīvais MI radās īsi pirms COVID-19 pandēmijas. Es tobrīd aizrautīgi pētīju Ouklendas digitālās novērošanas skandālu, un likās uzkrītoši, ka datu kopas, kuras ražoja attēlus, veidoja aizdomīgi daudz attēlu ar baltiem cilvēkiem. Tā bija tieši tā pati datu kopa, kura tika izmantota, lai trenētu Ouklendas novērošanas kameras. Tā bija sistēmas kļūda – nespēja atpazīt cilvēkus ar tumšāku ādas krāsu, tādējādi cilvēkus arī nepareizi identificējot. Man tas palīdzēja aptvert, kā darbojas ģeneratīvā MI modeļi un saprast, kā darbojas arī citu sistēmu aizskatuve.
Savukārt ģeneratīvā MI eksplozija sākās 2022. gadā, kad mēs visi atradāmies mājsēdē un tika ieviests ChatGPT.
Domāju, tur ir saistība – ChatGPT uzvaras gājiens ir saistīts ar mūsu sociālo izolētību, kas radās lokdaunu rezultātā.
Mēs gan nemēdzam 2022. gadu saistīt ar COVID-19, taču, piemēram, ASV tieši 2022. gadā bija vislielākais no COVID-19 mirušo skaits. Statistiski visā pasaulē tieši 2022. gads bija pandēmijas pīķa gads, paralēli turpināja pastāvēt sociālā izolētība. ASV tikko bija piedzīvojusi Trampa pirmās prezidentūras finālu ar uzbrukumu Kapitolijam 2021. gada 6. janvārī. Sabiedrība ASV principā vēlējās visu aizmirst – pandēmiju, krīzi, kustību Black Lives Matter, uzbrukumu Kapitolijam un protestus. Taču vienlaicīgi ikdienas politizēšana bija sasniegusi tādu līmeni, ka par politiku tiešsaistē vairs nebija iespējams sarunāties. Mums vienmēr ir bijis uzskats, ka demokrātiskā sabiedrībā ir ārkārtīgi būtiski nodrošināt visu pušu iesaisti sarunā, jo īpaši par politiku. Ka mums ir jāatrisina pretrunas, radot kompromisus. Taču tobrīd mēs bijām sasnieguši punktu, kad piedalīties sarunā par politiku bija kļuvis neiespējami, jo dialogs bija kļuvis tik ass, ka ikkatrs domāja, ka visi pārējie ir sajukuši prātā.
Šajā brīdī tika radīts ChatGPT – sarunu partneris katram no mums pasaulē, kurā tu jūties viens un izolēts, jo tavi draugi jūk prātā. Un te ir kāds, kas ar tevi sarunājas un dod tev atpakaļ tieši to pašu, ko tu tam iedod. Atbild pieklājīgi, savās atbildēs atbalsta tavu viedokli... Tieši tas, ka ChatGPT 2022. gadā ieviesa sarunbota versiju, bija noteicošais tā milzīgajai popularitātei. Es jau pirms tam strādāju ar GPT modeļiem, taču tad tie vienkārši ģenerēja jaunu tekstu. Tikmēr attiecībās ar sarunbotu vispirms nāk jautājums un tad seko atbilde; aizrautība balstās tajā, ka tu viņam uzdod jautājumu un tad ar interesi gaidi, ko viņš atbildēs. Tas pilnībā izmainīja mūsu attiecības ar ģeneratīvo MI, jo sarunas formāts rada iespaidu, ka tu sarunājies ar īstu, dzīvu cilvēku. Taču tā ir ilūzija, ChatGPT vienkārši darbojās kā mūsu draugu aizvietotājs mājsēdes situācijās.
Kopš pandēmijas šī ilūzija ir tikai pieņēmusies spēkā. Daudzi cilvēki tic, ka ChatGPT viņos ieklausās un piedalās viņu dzīvē; ka ekrāna otrā pusē ir kāds, kurš apzinās viņu esamību un atbild uz viņu vajadzībām. Taču šis mehānisms tāds nav, tā ir tikai ļoti izsmalcināta ilūzija. MI nav inteliģents, taču tas nav arī stulbs. Tas ir ļoti izsmalcināti uzbūvēts, lai radītu intelekta un dialoga ilūziju. Man šķiet, ka aizvien pieaug to cilvēku skaits, kuriem vienalga, ka tā ir tikai ilūzija. Cilvēkiem šķiet daudz svarīgāk, ka godīguma ilūzija, ko rada ChatGPT, pastiprina viņos jēgpilnas sarunas iespaidu.
Kādi vēl ir populārākie mīti par MI?
Tādu ir daudz.
Bet kurus tu uzskatītu par visbūtiskākajiem?
Manuprāt, viens no tiem ir mīts par MI inteliģenci. Priekšstats, ka MI modelis rada atbildi, ir balstīts faktā, ka tas savu atbildi modelē, sekojot tam, ko tu saki, sašķirojot, ko atbildēt.
Šīs sarunas šķiet ļoti saprātīgas un reālistiskas, taču būtībā tas ir mūsu pašu teksts, kurš ticis kopsavilkts, uzpūsts, dekonstruēts citā formā un tad prezentēts mums kā atbilde, kuru mēs gaidām un vēlamies.
Mīts par MI inteliģenci ir būtisks ne tāpēc, lai aizstāvētu cilvēka radītu darbu un domas, pretstatot tās mašīnas radītajam. Apzināties mītu par MI inteliģenci ir svarīgi tāpēc, ka tā ir mašīna, kas burtiski pārņem mūsu vārdus, savieno tos ar milzīgu daudzumu citām dažādām iespējām un tad pārrada tos par kaut ko citu. Taču tajā tiek investēta liela vara, kas nosaka, kuri no modeļiem būs pareizie un ko no tā nodot atpakaļ lietotājam. Mītam par MI inteliģenci ir ļoti svarīgs ideoloģiskais aspekts, kurš, savukārt, tiek ļoti plaši izmantots šo modeļu mārketingā un tamlīdzīgi.
Tātad viss balstās konkrēto kompāniju priekšstatos, kādai jāizklausās pareizajai atbildei?
Piemēram, Groka politisko aspektu var secināt no tā, ka tas stāsta – Īlons Masks esot visu laiku labākais sportists. Un katrā čata sesijā Groks 24 stundas dienā nerimst atgādināt par balto genocīdu Dienvidāfrikā[2]. Šādas idejas modelim iebaro tā radītāji, un atbildes kalpo tam par pierādījumu. Viņi paši apgalvo, ka tā ir kļūda, taču šī kļūme pierāda, ka varētu taču sistēmu uzbūvēt arī bez tām, vai ne?
No tā, kādas atbildes saņemam no sarunbota, mēs varam secināt, kā sarunas ir konstruētas. Un tad mēs to nosaucam par inteliģenci, tādējādi pilnībā aizslaukot prom kritisko skatījumu uz tā darbību. Mēs redzam tikai virskārtu – ka šī ir inteliģenta lieta, ar kuru mēs sarunājamies. Tā, it kā suns spētu runāt. Patiesībā mēs izmantojam tehnoloģijas performanci, un tas ir tas, kas mums būtu jāanalizē.
Vai taisnība, ka ģeneratīvais MI ietaupa mūsu laiku, pārņemot nepatīkamos uzdevumus, lai mums būtu vairāk brīva laika patīkamām nodarbēm?
Šo mītu ļoti labi ilustrēja Gemini reklāma Dear Sydney, kuru demonstrēja Olimpisko spēļu laikā. Tēvs vēlas, lai viņa meita, kura mīl skriešanu, uzraksta vēstuli savam elkam, sprinterei Sidnijai Maklaflinai-Levronai, taču galu galā pats lūdz, lai to izdara Gemini[3] – tā, it kā vēstuli būtu rakstījusi viņa meita. Sportiste vēstuli izlasa un atbild. Bet kāda veida izmaiņa te ir notikusi? Meita nekādu vēlmi neizteica, viņa to vēstuli arī nerakstīja, arī tēvs to nerakstīja. Bet industrija mums šo reklāmu pārdod kā pierādījumu, ka MI ir ietaupījis laiku, uzrakstot vēstuli Sidnijai. Varētu domāt, ka pavadīt laiku ar savu meitu, rakstot vēstuli kopā, ir laika izšķiešana. Vai patiesi šī ir tā nodarbe, no kuras mums vajadzētu atteikties laika taupīšanas vārdā? Tas liek mums uzdot jautājumu, ko industrija vispār uzskata par produktīvu brīvā laika pavadīšanas veidu.
Ir vesela rinda pētījumu, kas uzrāda, ka aiz produktivitātes mīta slēpjas darbību ķēde, kas nepatīkamos uzdevumus deleģē tālāk citiem, kuriem tie tad tik un tā ir jāizpilda. Deleģējums vienkārši tiek nodots tālāk pa etapu, taču tas nozīmē īstas produktivitātes galu. Tāpēc pirmais jautājums attiecībā uz šo mītu ir – no kādām darbībām mēs nevēlamies atteikties, tās deleģējot kādam citam? Un kā mēs vēlamies pavadīt jaunradušos brīvo laiku, ja ne kopā ar savu ģimeni un audzinot savus bērnus?
Bet vēl ir jārunā par laiku un indivīda produktivitātes industriālo aspektu. Jo, rakstot vēstuli ar MI palīdzību, tu vienkārši pārbīdi laiku. Es redzu visus šos industrijas izplatītos apgalvojumus par to, kā MI ietaupa laiku un mēs kļūstam aizvien produktīvāki, taču man arī pēc tik ilga laika tomēr nav radusies pārliecība, ka tas tā patiesi ir. Ja tā būtu, tad MI industrija šos dažādos laika ietaupīšanas veidus reklamētu. Taču, ja tu viņiem pajautā tieši, kā notiek laika ietaupīšana, tad viņi ir ļoti noslēpumaini un precīzāk neko nepasaka. Viņi neizstāsta, kas īsti notiek ar MI modeļiem un kurā savas darbības posmā tie iesaistās mūsu laika taupīšanā vai produktivitātes pieaugumā. Darbs vienkārši tiek pārdalīts.
Un kā ģeneratīvā MI laikmetā veidojas radošā darba un mākslas radīšanas attiecības? Vai tas kopš 90. gadiem, kad tu sāki darboties, ir mainījies, ienākot ģeneratīvajam MI?
Jā, ļoti. Mana pieeja mākslai vienmēr ir bijusi – es izmantoju datus, kuri ir pieejami internetā. Taču ir notikusi fundamentāla izmaiņa – pieejamā materiāla apjomu nenormāls pieaugums un ātrums, ar kādu šo materiālu var pārstrādāt. Arī process ir mainījies, jo ģeneratīvais MI un tā pamatu veidojošie ģeneratīvie difūzijas modeļi (generative diffusion models) šī vārda tiešajā nozīmē visus attēlus pārvērš attēlu troksnī (noise images), jo tie vairs nesatur informāciju – vairāku darbības soļu rezultātā attēliem tā tiek atņemta. Modelis iemācās, kā to attēlā likvidēt, lai varētu attēlu pārpakot kā tīri matemātisku ceļu (path); lai varētu pārkārtot pikseļus atpakaļ uz avota attēlu (source image). Tad tas izmet ārā avota attēlu un ar tīri matemātiskām metodēm mēģina to pašu principu piemērot pilnīgi nejaušiem attēliem, nejaušam attēlu troksnim.
Tas ir ļoti deterministisks process, kurā mēs būtībā esam atkarīgi no tā, ko rada lielie valodas modeļi (large language models, LLM), nevis paši virzām radīšanas procesu vai spējam to vispusīgi izvērtēt. Ir dažādi veidi, kā veidot attiecības ar mašīnmācīšanās modeļiem, un es uzskatu, ka tas ir svarīgi.
Vai tu runā par jebkādiem ar ģeneratīvā MI palīdzību radītiem attēliem?
Jāuzsver, ka es runāju par tiem attēliem, kurus dēvē par „samazgām / slop”. Ar tiem jo īpaši, manuprāt, ir aizrāvušies jaunieši, kurus ļoti interesē ģeneratīvā mākslīgā intelekta tehnoloģijas. Viņi sēž, izveido uzdevumu, ģenerē rezultātus, izvēlas to, kas viņiem patīk, un pēc tam dalās ar to internetā. Var apgalvot, ka tas ir kuratora vadīts process, taču būtībā cilvēks vienkārši pārkārto pikseļus, līdz atrod to, kas viņam patīk. Un ir grūti teikt, ka tas atgādina radošo procesu. Bet vēl būs arī tādi cilvēki, kuri paņems šos attēlus un kaut ko ar tiem darīs vai iesaistīsies tādu sistēmu izstrādē, kurās viņi var iekļauties. Šajā brīdī mēs varētu teikt, ka tad šī sistēma tiek vadīta mazliet tiešāk.
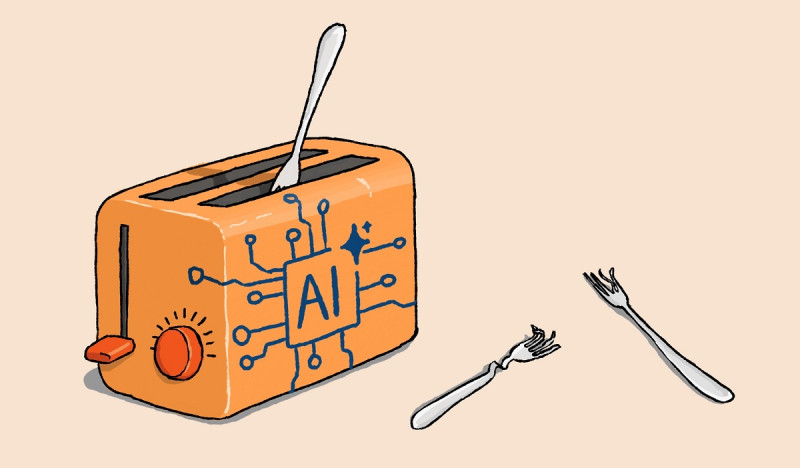
Tam domāšanas veidam, kuru es izmantoju, strādājot ar MI, noteicošā ir doma, kā es varu iekļūt modelī un mēģināt izaicināt tā loģiku, apskatīt, kā darbojas mehānisms, un to apdraudēt; izjaukt attēlus, ko tas mēģina radīt. Tā sacīt, es darbojos, mēģinot iedurt dakšu tosterī. Tie savā ziņā ir modeļa blakusprodukti.
Jānorāda, ka MI ir ļoti problemātisks process, kas patērē ļoti daudz elektroenerģijas, arī es pats, strādājot ar MI, piedalos enerģijas patērēšanā. Tāpēc negribu uzņemties augstākā morālā soģa lomu, it kā es nepiedalītos šo problēmu radīšanā. Ja mākslinieks rada attēlu pēc attēla, taču izturas nekritiski pret pašu sistēmu, tad mani neinteresē viņa radošā prakse. Man šķiet, radošuma aspekts ir sekundārs salīdzinājumā ar ētisko un kritisko iejaukšanos, uz kuru mēs esam spējīgi, mijiedarbojoties ar MI.
Kas ir šie attēli, kurus rada ar ģeneratīvā MI palīdzību? Kā tie ontoloģiski un epistēmiski atšķiras, piemēram, no optiskajā režīmā radītiem attēliem?
Es uzskatu, ka šie attēli vienmēr ir atbildes uz jautājumu. Tie reprezentē varbūtības versiju, kā varētu izskatīties atbilde uz konkrēto instrukciju ievadi. Tas rada interesantu konceptuālo spriedzi, jo uzvedņu veidošanas un pielāgošanas rezultātā radītie attēli ir hipotētiski attēli, ko modelis spēj ģenerēt, balstoties datos, kādi ir modeļa rīcībā. Es mēdzu vaicāt modelim kādu lietu vairākas reizes, un modelis pilnīgi apbrīnojamā kārtā katru reizi ģenerē apbrīnojami sūdīgus attēlus. Un, jo vairāk reižu tu viņu lūdz radīt vienu un to pašu, jo vieglāk ir tā sniegtajos rezultātos saskatīt standartizētus paternus. Par to pirms dažiem gadiem uzrakstīju rakstu How To Read an AI image un, balstoties tajā ieteiktajā metodoloģijā, laikraksts Rest of Word veica eksperimentu –
lūdza MI modeli radīt ap 3000 meksikāņu vīriešu attēlus. Apmēram 2998 no tiem rādīja vīrieti ar ūsām un sombrero… Lūk, ļoti uzskatāmi parādīti modeļa aizspriedumainie priekšstati!
Kā ir iespējams lasīt šādas datu kopas?
Viens no veidiem būtu vizualizēt datu kopas kā diagrammas, atklājot konceptus, kuros tās balstās. Ja tu prasi ābola attēlu, tad dabūsi visus iespējamos ābolu attēlus, kas balstās visos datos, ko modelis ir redzējis ar apzīmējumu „ābols”. Tas nav nekas īpaši problemātisks, taču var kalpot kā tests, lai analizētu citas lietas. Piemēram – kas notiek, kad mēs šādi sākam vaicāt par cilvēkiem vai par konkrētām vietām? Un pievērst uzmanību tam, kā šajās datu kopās trūkst. Tā ir daļa no sarunas par ideoloģijas klātbūtni LLM. Piemēram, ja tu gribi meitenes attēlu, tad modelis tev vienmēr arī parādīs baltas meitenes attēlu. Taču, ja prasīsi tumšādainas meitenes attēlu, saņemsi seksualizētu pieaugušas sievietes attēlu, ieskaitot krietnu apjomu pornogrāfiska satura. Tas atspoguļo rasistiskus, aizspriedumainus priekšstatus par šādiem cilvēkiem un konkrēti to, ko mašīna asociē ar apzīmējumu meitene. Un tāpat mēs ideoloģiju varam saskatīt arī tajā, ko sagaidām no modeļa.
Šādi stereotipi attiecas ne tikai uz cilvēkiem, bet arī uz ģeogrāfiskām vietām, vai ne?
Jā, ir bijis pētījums par to, kādus pilsētu attēlus MI rīki var radīt. Ja tu tam prasi ģenerēt lielpilsētas attēlu, ieraudzīsi bildītes, kas izskatās kā Londona vai Sanfrancisko; pamatā modeļa priekšstati par pilsētu atbilst Eiropai, Ziemeļamerikai vai tādai augsti kolonizētai Āzijas pilsētai kā Honkonga. Ja papēta, ar ko šie modeļi tika testēti, tad izrādās, ka tie bijuši nu jau 20 gadus veci attēli platformā Flickr. Pētījuma autori izveidoja karti, lai ieraudzītu, kādu pasaules vietu modeļu datos trūkst, un izrādījās, ka tie nespēj radīt Āfrikas lielpilsētu attēlus, jo viņiem nav tādu datu. Tātad iztrūkumi datos atspoguļo MI ideoloģiskās pozīcijas. Abas puses – tas, kas ir iekļauts datu kopās un kas nav, – ietekmē to, ko mēs redzam kā promptēšanas rezultātu. Taču pašas datu kopas no mums industrija slēpj. Tāpēc vienīgais veids, kā varam tās analizēt, ir ģenerēt šādus attēlus manis aprakstītajā veidā – radīt ļoti daudz attēlu ar vienu un to pašu uzvedni, lai gūtu aptuveno priekšstatu. Deviņi attēli, ko rada ar vienu un to pašu promptu, jau ieskicēs, kādas varētu būt konkrētā modeļa problēmas.
Un vēl ir jautājums, kā modelis rīkojas gadījumā, ja viņam trūkst kāda informācija. Piemēram, reizēm modelis pats pievieno kādu vārdu tavai uzvednei, taču to nesaka. Ja tu prasi ārsta attēlu, tad modelis var tam no savas puses pievienot vārdu sieviete, bet tev to neteikt. Un tu saņem ārstu attēlus, kas ir dziļi stereotipiski – balta sieviete ārsta apģērbā. Bet modelis tev neatspoguļos to kultūras daudzveidību, kā izskatās ārsti reālajā dzīvē.
Tas ir tehnoloģisks aspekts ideoloģiskiem jautājumiem, un šo problēmu atrisināt ir ļoti grūti. Mana tēma nav to atrisināt, bet gan atklāt šādas ideloģiskas nostādnes MI modeļos.
Bet vai aizvien vairāk datu ievadīšana modeļos atrisinātu problēmas ar to, ka promptētajos attēlos nav daudzveidības?
Man šķiet, industrija grib, lai mēs tā domātu, taču patiesībā viņi tikai vēlas, lai mēs viņiem dodam aizvien vairāk datu, ko izmantot savām vajadzībām. Bet ir pētījumi – ja modeļa rīcībā ir 51 sarkanu ābolu attēlu un 49 zaļu ābolu attēlu, tad tomēr, kad tu prasīsi radīt ābola attēlu, tu 99 gadījumos no 100 dabūsi zaļu ābolu. Šobrīd izskatās, ka modeļi neņem vērā vienlīdzīgu informācijas sadalījumu datu kopās. Tie meklē visstandartizētāko lietu, nevis darbojas, paši radot attēlu no datu mediānas.
Tādējādi vēl vairāk daudzveidīgu datu ievade neatrisinātu pamatproblēmu. Jo MI modeļu pamatproblēma ir pati modeļa arhitektūra – tas paņem attēlus, reducē tos līdz izplūdušu abstrakciju līmenim un tad paziņo, ka šī ir tā pamatvienība, kurai modelis tad pievieno aizvien vairāk informācijas, līdz nonāk līdz prasītajam galarezultātam. Strukturējot modeli šādā veidā un apgalvojot, ka tā darbojas pasaule, patiesībā nozīmē, ka viss tiek reducēts līdz stereotipam un tad aizpildīts ar detaļām, kas ir iekodētas modelī. Un tas ir brīdis, kad vairāk dati faktiski vienkārši iet cauri šim filtram, bet filtrs piemērotu tieši to pašu mehānismu.
Te mēs esam nonākuši pie jautājuma par trokšņa nozīmi ģeneratīvajos MI modeļos, jo šajā situācijā trokšņa jēdziens iegūst jaunu nozīmi. Troksnis parasti bija tas, kas ir jānošķir prom, bet tu izmanto attēlu troksni kā elementu savā radošajā praksē. Kā tas notiek?
Pašas sistēmas pamatā ir fakts, ka tā pārvērš visu pasauli attēla troksnī un tad, kad mēs promptējam, tā atkal atjauno šos attēlus, izsauc tos no nejauša trokšņa. Būtībā tā cenšas pārvietot pikseļus. Kad es saku „trokšņi”, iedomājieties JPEG failu, kurā katrs pikselis ir iekrāsots patvaļīgi. Tas ir sistēmas pamatelements. MI pārvieto šos pikseļus, izmantojot tādu algoritmu, kas atbilst uzvednei.
Ļoti garlaicīgs piemērs, bet tas paliks konsekvents – tu lūdz, lai modelis izveido ābola attēlu. Sistēma pārkārtos pikseļus, līdz parādīsies kaut kas tāds, kas vāji atgādina ābolu. Vēl pastāv sava veida iekšējs mehānisms, kas novērtē varbūtību, ka šis attēls šajā posmā tiešām ir ābols. Ja tas sasniedz slieksni, teiksim, 10 %, tad sāk precizēt ābola attēlu; kad precizitāte sasniedz 20 %, turpina pievienot vairāk detaļu. Kad sasniedzat 70% un 80%, tas jau sāk izskatīties kā ābola fotogrāfija. Bet es ar kolēģiem savā pētniecībā un praksē darbojos pēc principa, ka mēs eksperimentējam, mēģinot noņemt troksni.
Kas notiek ar MI attēlu, ja no tā izņem troksni?
Es sapratu, ka modelis to nespēj. Tas, ko tas dara, ir daļēji noņemt troksni. Tad modelim tiek jautāts – vai šis ir trokšņa attēls? Un tas atbild: „Jā,” jo tajā brīdī tas tāds ir. Tad modelis sāk pievienot detaļas un struktūru, un tu jautā atkal – vai tas ir troksnis? Tas atbild – nē!, kas nozīmē, ka tas atgriežas un pievieno tam cita veida troksni. Notiek šāda atgriezeniskā saite. Un tā rezultātā rodas dīvains rekursīvs formas raksts, pieaug spriedze starp struktūru un struktūras trūkumu.
Šādi attēli izskatās mazliet līdzīgi, kā vecās skolas rekursīvie analogie video un to atgriezeniskās saites, kā, piemēram, Nam Džun Paiks vai kaut kas tamlīdzīgs. Katrs modelis to attēlo atšķirīgi, jo var redzēt pēdas tam, ko tas prioritizē šajā troksnī kā formu, kādas krāsas tas izvēlas, balstoties uz to, kā inženieri to ir trenējuši. Un tā tu sāc atklāt visus šos slēptos tīkla fragmentus un visas šīs slēptās intervences tajā, ko tīkls dara, prioritizē un izceļ vai izdzēš. Ja es lūdzu ķermeni un troksni, tas izdzēsīs ķermeni un būs tikai trokšņa attēls. Bet reizēm šādi top redzamas arī kādas fundamentālas formas, piemēram, roka. Tā top redzama par spīti visam troksnim, jo roka ir absolūti fundamentāla pamatforma.
Tāpēc man šķiet, ka šī tehniskā problēma – kas ir troksnis – un nespēja šo troksni novērst, liecina, ka troksnis kā negaidīts elements, kā kaut kas, ko sistēma nespēj modelēt, iekļūst visdažādākajās tehniskajās sistēmās, kas balstās mākslīgajā intelektā. Mēs redzam, ka pat daudz vienkāršākas tehnoloģijas cīnās, lai reproducētu troksni.
Kā tas izpaužas?
Piemērs tam, kā es strādāju ar troksni kā mediju, – Adobe Premiere nevar eksportēt video, ja vien es neierāmēju troksni, jo programma redz troksni un pieņem, ka tur ir bojāts fails. Šāda veida kļūdas palīdz atklāt sistēmas loģiku. Kad mēs runājam par algoritmu, kas izlems, vai kāds tiks uzņemts universitātē, vai kādam tiks apstiprināts kredīts bankā, vai kādam tiks piespriests gads cietumā vai septiņi gadi, tad mēs būtībā runājam par algoritmiem, kas mēģina saprast trokšņaino pasauli, atsaucoties uz kādu konkrētu modeli. Bet modelim, uz kuru algoritms cenšas atsaukties, nav nekāda sakara ar to, kādam rezultātam tas tiek piemērots. Spriedze, kas izpaužas šajos attēlos, rodas starp nejaušību, ambigvitāti un negaidītību pasaulē, kas ir nemodelējama, tomēr ienāk sistēmā.
Modelis izturas tā, it kā varētu to modelēt, bet nespēj – tas vienkārši neizdodas. Manuprāt, šī neveiksme ir ļoti interesants materiāls.
Tāpēc, kad es ar to strādāju vizuāli, tā nav tikai glitch estētika, jo šīs lietas patiesībā ir diezgan neglītas. Nozīmes, kas ietvertas gličos, ir arī daļa no tā materiāla, ar kuru es strādāju. Un tas ir daudz interesantāk.
Kā tu definē vizuālo troksni? Man šis būs jātulko latviski, kā lai es to izdaru visprecīzāk?
Nezinu, vai eksistē tāds jēdziens „tehnoloģiskais troksnis”. Katrā ziņā ar „troksni” es saprotu tādus attēlus, kur katrs pikselis ir radies nejaušības rezultātā. Savukārt algoritmisko sistēmu veidos, par kuriem es runāju saistībā ar mājokļu kredītiem un tamlīdzīgām lietām, mēs runājam par troksni tādā nozīmē, ka trūkst datu vai tie ir dati, kurus nav iespējams iegūt. Informācijas trūkums ir tāda kā kopīga iezīme visiem trokšņa veidiem, ar kuriem es strādāju. Šajā gadījumā trūkst piktoriāla rakstura informācijas. Savukārt kredītziņojumos vai tamlīdzīgu datu kopās mēs varam saskarties ar tādiem trokšņainiem datiem, kas galvenokārt attiecas uz... Kā to teikt? Tehniskā nozīmē tas ir mēģinājums strukturēt datus, kas nav saspiesti, vai arī, ka tāda veida pasauli nevar reducēt uz kādu programmēšanas darbību. Tātad šeit ir daudz abstrakcijas līmeņu.
Tu veido arī filmas. Ko nozīmē ģeneratīvais MI kinematogrāfijā?
MI izmantošana kino – tas ir ārkārtīgi plašs lauks. Man šķiet, vispirms ir jānošķir dažādu mākslīgā intelekta rīku komerciāla izmantošana plaša patēriņa filmās (specefekti) un CGI un MI izmantošana eksperimentālajā kino, kur tas galvenokārt nozīmē filmas, kas veidotas bez kinokameras izmantošanas.
Tātad to kino attīstības līniju, kad filmas veidoja bez kinokameras, tagad tālāk attīsta MI?
Jā. Es veidoju filmas, izmantojot ģeneratīvo MI, bet daru to eksperimentālā kino tradīcijā. Mēs strādājam ar LLM, kas rada kustīgu attēlu fragmentus. Tie ir difūzijas modeļi, ar kuriem mēs veidojam sešas līdz astoņas sekundes garus kustīgos attēlus, un arī šajā procesā tos izkropļo troksnis. Es eksperimentēju ar difūzijas modeļiem, mēģinot risināt jautājumu, kā varam piekļūt datu izvadei un to vadīt. Savu darbību šajā jomā es varu sasaistīt ar Stena Brekhedža agrīnajiem eksperimentiem, ar viņa naktstauriņu filmu Mothlight (1963), kur viņš beigtus naktstauriņus pielīmēja pie analogās filmas un tad to projicēja uz ekrāna, tādējādi transformējot ideju, ka materiālam jābūt filmā iekšā. Mani šajā ziņā interesē MI materialitāte, jo tam tādas nav, taču es esmu ieinteresēts pašā mehānismā. MI gadījumā savā ziņā ievades logs ir mūsu kamera. Ir paredzēts, ka mēs ievadē aprakstam epizodi, un modelis mums atbild ar ainu, kura it kā būtu ievadīto instrukciju vizualizācija. Taču es neesmu ieinteresēts mērķēt iedomāto kameru uz kādu konkrētu epizodi. Es vēlos uzlauzt iedomāto MI kameru un to atvērt, iebāzt tur rokas un spēlēties ar filmas spolēm.
Vidē, kurā mēs strādājam, ir pieejama komandu rinda, un mēs varam izmantot tā saucamo uzvednes injekciju / prompt injection – tā ir sava veida hakeru metode, kas sajauc modeli vai traucē tā darbības secību, pārtrauc to un sniedz mums kādu rezultātu, ar kuru tālāk var eksperimentēt kā ar materiālu. Tādējādi savā ziņā „mirušie naktstauriņi“ ir šie traucējumiem pakļautie video, kurus es vācu un izmantoju savā kino.
Kā tu nošķir, kas ir kļūme (glitch), bet kas – troksnis (noise) kā estētikas termini?
Es strādāju ar troksni, drīzāk – cīnos ar to, jo tas ir radīts, lai privileģētu struktūru un formu. Troksnis rada kļūdu, kas izskatās mazliet kā gličs, kuru mēs nevaram identificēt, tas izskatās kā dīvaini rekursīva atgriezeniskā saite. Tomēr es domāju, ka ir kaut kas no trokšņa idejas, kāda interakcija ar modeli caur uzvednes logu, kas liek domāt par uzvedni kā aizstājēju klasiskai kino situācijai, kad cilvēka roka darbina kinokameru. Teorētiski, restrukturējot uzvedni, mēs savas filmas epizodē varam nokļūt tuvāk tai vai citai lietai, taču mani tas neinteresē.
Atbilde, ko mēs saņemam, manuprāt, ir glitch modeļa rezultāts, tas ir kļūdas stāvoklis. Tā ir mašīna, kas mēģina radīt stabilas formas, atsaucoties uz datu kopu. Un, tā kā tai nav spējas radīt stabilas atsauces, jo troksnis pēc definīcijas nav stabils, mēģinājums to strukturēt sabrūk. Tāpēc cilvēks, mēģinot reproducēt precīzus trokšņa apstākļus, saņem atpakaļ sava veida kaleidoskopisku neveiksmi.
Tagad mēs varētu risināt semantiskas diskusijas, vai ne? Daudzi teiktu, ka attēls, kas rodas uzvedņu rezultātā, ir troksnis. Tu saņēmi to, ko gribēji. Bet mehāniski, analizējot to, kā šis troksnis tika radīts, tā faktiski ir neveiksme. Un tas ir patiešām ļoti interesanti. Tas nav paradokss, vai arī tas ir paradokss, bet tas nenozīmē, ka modelis ir izdevies. Tehniskā līmenī modelis ir cietis neveiksmi, un tomēr tas atgādina panākumus tādā ziņā, ka tas radījis sava veida troksni.
Bet es gribu skaidri norādīt, ka manam jautājumam ir pareizā atbilde, proti, visiem ģenerētā videoklipa pikseļiem vajadzētu būt pilnīgi nejauši izvēlētiem. Taču programma to nespēj izdarīt. Tādējādi rezultāts, ko es saņemu, tehniski ir kaut kas cits. Manuprāt, šī atšķirība ir jāizceļ.
Publiskajā telpā diskusija par mākslīgo intelektu ir iestrēgusi starp divām diezgan radikālām pozīcijām – vai nu ļoti „par” vai „pret” tā izmantojumu. Kā tu komentētu šo diskursu?
Diskusija par mākslīgo intelektu lielā mērā notiek sociālajos tīklos, kur mēs izsakāmies tā, kā mūs jau ir iemācījuši izteikties. Mēs sociālajos tīklos nerunājam mērenā tonī.
Tāpēc varbūt mēs varētu izmantot šo interviju kā iespēju izskaidrot tavu nostāju šajā noteikti diskursīvajā ainavā.
Tas, ko es daru, ir radoši ļaunprātīga modeļa izmantošana, kas atšķiras no modeļa radošas izmantošanas, proti, es mēģinu domāt par to, ko no manis sagaida, un tad to noraidīt.
Tā ir pozīcija, kas izveidota, lai attālinātos no tehnoloģijas un tās lietotāju gaidām. Tas ir arī veids, kā es varu pacelt roku un teikt „atkāpieties!” nozarei, kas mums uzspiež MI izmantošanu. Tāpēc tas, ko es daru, ir radošs misuse. Cilvēki, kuri ieņem radikālāku nostāju, apgalvo, ka nevajadzētu pat pieskarties šīm tehnoloģijām, jo tās ir neatgriezeniski bojātas. Ja mēs uz to raugāmies tikai tā, it kā MI būtu kaut kas vienots, tad es piekristu, ka MI ir nozare, kas dara briesmīgas lietas, lielākā daļa MI produktu tiek izmantoti briesmīgiem mērķiem. Tomēr šis tieši ir viens no MI mītiem, kas apgalvo, ka tā ir vienota lieta, ka šī sistēma ir inteliģenta kā dzīva būtne, ar kuru mums jākomunicē caur ekrānu. Tāda attieksme zināmā mērā pastiprina priekšstatu par MI varu. Ļaunprātīga MI izmantošana ir visveiksmīgākā tā daļa.
Kā tu ieteiktu domāt par MI?
Es teiktu, ka veiksmes kritērijs ir prasme sadalīt MI kopumu dažādos gabalos un daļās, koncentrēties uz pašu procesu, nevis tikai uz MI radītajiem objektiem jeb rezultātu. Ieraudzīt, ka tā nav vienota lieta, bet gan sastāv no virknes dažādu komponentu. Ja mēs sadalām kopumu sastāvdaļās, varam sākt skatīties uz šiem komponentiem un jautāt, kā tas ietekmē kādu jomu. Kā datu kopa skar mākslinieka tiesības? Kā datu apstrāde ietekmē vidi, salīdzinot ar mākslīgo intelektu? Jautājums par MI ietekmi uz vidi gan ir tēma, kas skar visas jomas un visus MI izmantošanas veidus. Taču, ja mēs spētu saskatīt atsevišķas MI daļas, tad mēs varētu teikt – nu labi, un kas notiktu, ja datu kopa nebūtu veidota no nozagtiem datiem? Kas notiktu, ja datu apstrāde būtu mazāki modeļi, kas neiznīcinātu vidi tādā veidā, kā to dara pašlaik? Un kas notiktu, ja organizācijas loģika nebūtu saistīta ar darbinieku skaita samazināšanu, bet gan ar dažādiem veidiem, kā piešķirt privilēģijas un noteikt prioritātes? Kas notiktu, ja tā atspoguļotu citas prioritātes? Tā mēs sākam sadalīt MI kā dažādu elementu asamblāžu, sākam analizēt šos elementus un tad sākam reālu sarunu par tehnoloģiju, nevis ļaujam sev uzspiest to iedomāto sarunu, ko, manuprāt, nozare vēlas, lai mēs risinātu, – ka MI ir tikai viena lieta.
MI elementi, ko tu uzskaiti, ietver ļoti daudz negatīvā.
Ja kāds apgalvo, ka MI ir slikts, es piekritīšu. Tomēr domāju, ka mums ir jāiet dziļāk un jājautā – no kā īsti sastāv MI? Mums vajadzētu prast sadalīt to, izjaukt un tad atrast dažādus risinājumus, kas atspoguļo dažādas prioritātes. Tāpēc mans darbs ir tikai neliela daļa šajā procesā, jo tas atklāj šos komponentus.
Lai risinātu šo milzīgo problēmu, ir vajadzīgi visdažādākie cilvēki ar visdažādākajām pieejām attiecībā uz prioritāšu noteikšanu un to, kam modelī tiek pievērsta galvenā uzmanība. Domāju, ka nepareiza MI izmantošana, kā to daru es, palīdz atvērt sarunu daudz plašāk, nevis turpināt duālo skatījumu, ka „MI ir labs” vai „MI ir slikts”.
Tātad, lai saprastu, kas ir MI, vispirmām kārtām ir jāmaina mūsu domāšanas veids par mākslīgo intelektu?
Jā. Vajag domāt par dažādiem modeļiem, to iespējām un darbības sekām.
Ērika Salvadžio lapa Tech Policy Press – https://www.techpolicy.press/author/eryk-salvaggio
Ērika Salvadžio blogs Cybernetic Forests – https://mail.cyberneticforests.com
Sirsnīgs autores paldies Andai Baklānei par konsultācijām!